tl;dr Der Autor scannt mit einem HP Multifunktionsgerät, das schief einzieht, keine Leerseiten kennt und von Lochrändern nichts weiss. Paperless-ngx bügelt für die Archivkopie manches aus, aber lange nicht alles. Den Rest erledigt jetzt ein mit Claude Opus 5.5 selbstgebautes pre-consume.sh – ohne dass dafür auch nur ein Pixel des Scans neu berechnet wird.
Papier vs. PDF
Seit Ende 2023 benutze ich Paperless-ngx als digitales Dokumentenarchiv. Es läuft auf meinem Home Server und schluckt alles, was an Dokumenten anfällt. Zwei Sorten Dokumente, die unterschiedlicher nicht sein könnten:
Papier: Arztrechnungen, Nebenkostenabrechnungen, Steuerbescheide. Von der laufend eingehenden Post abgesehen ist das meiste gelocht, weil es jahrelang im Ordner stand. Das Recyclingpapier vom Finanzamt ist grau, die Geburtsurkunde 50 Jahre alt, vergilbt und mit Wasserflecken. Das alles muss durch den Scanner.
Digital: Mailanhänge laufender Bank- und Versicherungspost, Rechnungen, Garantiezertifikate der Haushaltsgeräte. Die Dokumente sind sauber, haben echten Text und brauchen keinerlei Nachbehandlung. Im Gegenteil – wer daran herumkorrigiert, macht sie schlechter.
Beide Sorten landen im selben Consume-Ordner, und da fängt die Arbeit an.
Der HP OfficeJet Pro 9132e
Gescannt wird mit einem HP OfficeJet Pro 9132e. Und zwar mit Absicht so: ein Alleskönner statt zwei Spezialisten mit zwei Kaufpreisen und zweifachem Platzbedarf. Multifunktionsgeräte sind allerdings zuerst Drucker und erst an zweiter Stelle Netzwerkscanner.
Scannen ist beim HP also der Nebenjob. Und da hat er drei Schwächen, die ein dedizierter Dokumentenscanner nicht hätte:
- Schräglauf. Auch wenn das Papier vollkommen gerade eingezogen wird, kommt der Scan leicht schief heraus. 0,45 Grad klingen nach nichts, sind aber wahrnehmbar: über eine Zeile in voller Seitenbreite sind das 1,6 mm Höhenunterschied. Und die 0,45 Grad sind noch geschönt. Meine Testseiten habe ich penibel angelegt, und war ich mit dem Ergebnis nicht zufrieden, gab es einen zweiten oder dritten Scandurchlauf unter Aufsicht. Legst Du dagegen einen ganzen Stapel auf, den der ADF unbeobachtet abarbeitet, wird es schiefer.
Aber genau so soll es ja laufen: Dokumente in den Einzug schmeissen, Scan starten, später wiederkommen. Danebenstehen und nachscannen zerstört jede Automation. Ursächlich liegts am Gerät und daran, wie es das Blatt an der Scanzeile vorbeizieht. Vorder- und Rückseite laufen übrigens spiegelbildlich schief, weil zwei Sensoren dasselbe Blatt von beiden Seiten sehen. - Keine Leerseitenerkennung. Duplex scannt jede Rückseite mit, auch die leeren. Und eine leere Rückseite mit Lochung ist für jede einfache Leerseitenerkennung: nicht leer.
- Keine Texterkennung. Raus kommt ein reines Bild-PDF, ein JPEG pro Seite. Durchsuchbar ist da nichts.
Dazu kommt eine Eigenheit, die beim Testen auffiel: der Hintergrund im Einzug ist weiss. Ein Loch erscheint deshalb nicht als dunkler Kreis, sondern nur als feiner Halbmond-Schatten an der Lochkante. Und die Blattkante hinterlässt gern eine dünne graue Linie am oberen und/oder unteren Rand.
Was Paperless kann. Und was nicht.
Paperless ist gut darin, aus einem Bild-PDF ein durchsuchbares Dokument zu machen. Intern läuft dazu OCRmyPDF mit Tesseract, und zu jedem Original entsteht eine Archivversion mit Textebene. Das Original bleibt unangetastet. Das ist eine Stärke: das Original ist der echte Scan, die Archivversion die aufbereitete Arbeitskopie.
Es ist aber auch die Grenze. Was Paperless korrigiert, korrigiert es nur in der Archivversion, und dort wird jede korrigierte Seite neu gerastert + neu komprimiert. Manches kann Paperless auch gar nicht. Sieht dann so aus:
| HP 9132e | Paperless Archiv | pre-consume.sh | |
|---|---|---|---|
| Text durchsuchbar machen | nein | ja, per OCR | nicht nötig |
| Seite steht auf dem Kopf | nein | ja, dreht in 90-Grad-Schritten | nicht nötig |
| Schräglauf ab 0,15 Grad | nein | ja, Seite wird neu gerastert + komprimiert | ja, verlustfrei per Drehmatrix |
| Leere Rückseiten | nein | nein | ja, auch mit Lochung |
| Lochung | nein | nein | ja, überdeckt in Papierfarbe |
| Grauer Kantenschatten | nein | nur mit clean-final, per unpaper mit Risiko | ja, übermalt in Papierfarbe |
| Digitale PDFs in Ruhe lassen | – | ja, nur PDF/A-Umwandlung | ja, erkennt sie und bricht ab |
Die Spalte rechts ist die Lücke. Bleibt die Frage, warum ich den Deskew des Schräglaufs nicht einfach Paperless überlasse (Schalter PAPERLESS_OCR_DESKEW)? Siehe oben, der wirkt nur in der Archivversion und rastert dort neu. Mein Skript dreht die Seite, ohne das JPEG anzufassen. Paperless-Deskew ist bei mir deshalb aus, sonst wird doppelt gedreht.
Kantenschatten: mit der Standardeinstellung PAPERLESS_OCR_CLEAN=clean bereinigt unpaper die Seite nur für die Texterkennung, in der Archivversion ist davon nichts zu sehen. Erst mit clean-final landet die bereinigte Seite auch dort.
jetzt aber: pre-consume.sh
Paperless bietet dafür einen Hook: ein Skript, das läuft, bevor ein Dokument verarbeitet wird. Es bekommt eine Arbeitskopie und darf daran ändern, was es will. Was hinten rauskommt, speichert Paperless als [neues] Original.
Mein Skript arbeitet in fünf Phasen und hat eine eiserne Regel: Die Bilddaten des Scans werden nie neu kodiert. Jede Korrektur, ausser dem Löschen leerer Seiten, ist eine zusätzliche PDF-Anweisung über dem unveränderten JPEG. Ein Rechteck, ein Kreis, eine Drehmatrix. Verlustfrei, und sogar wieder rückgängig zu machen.
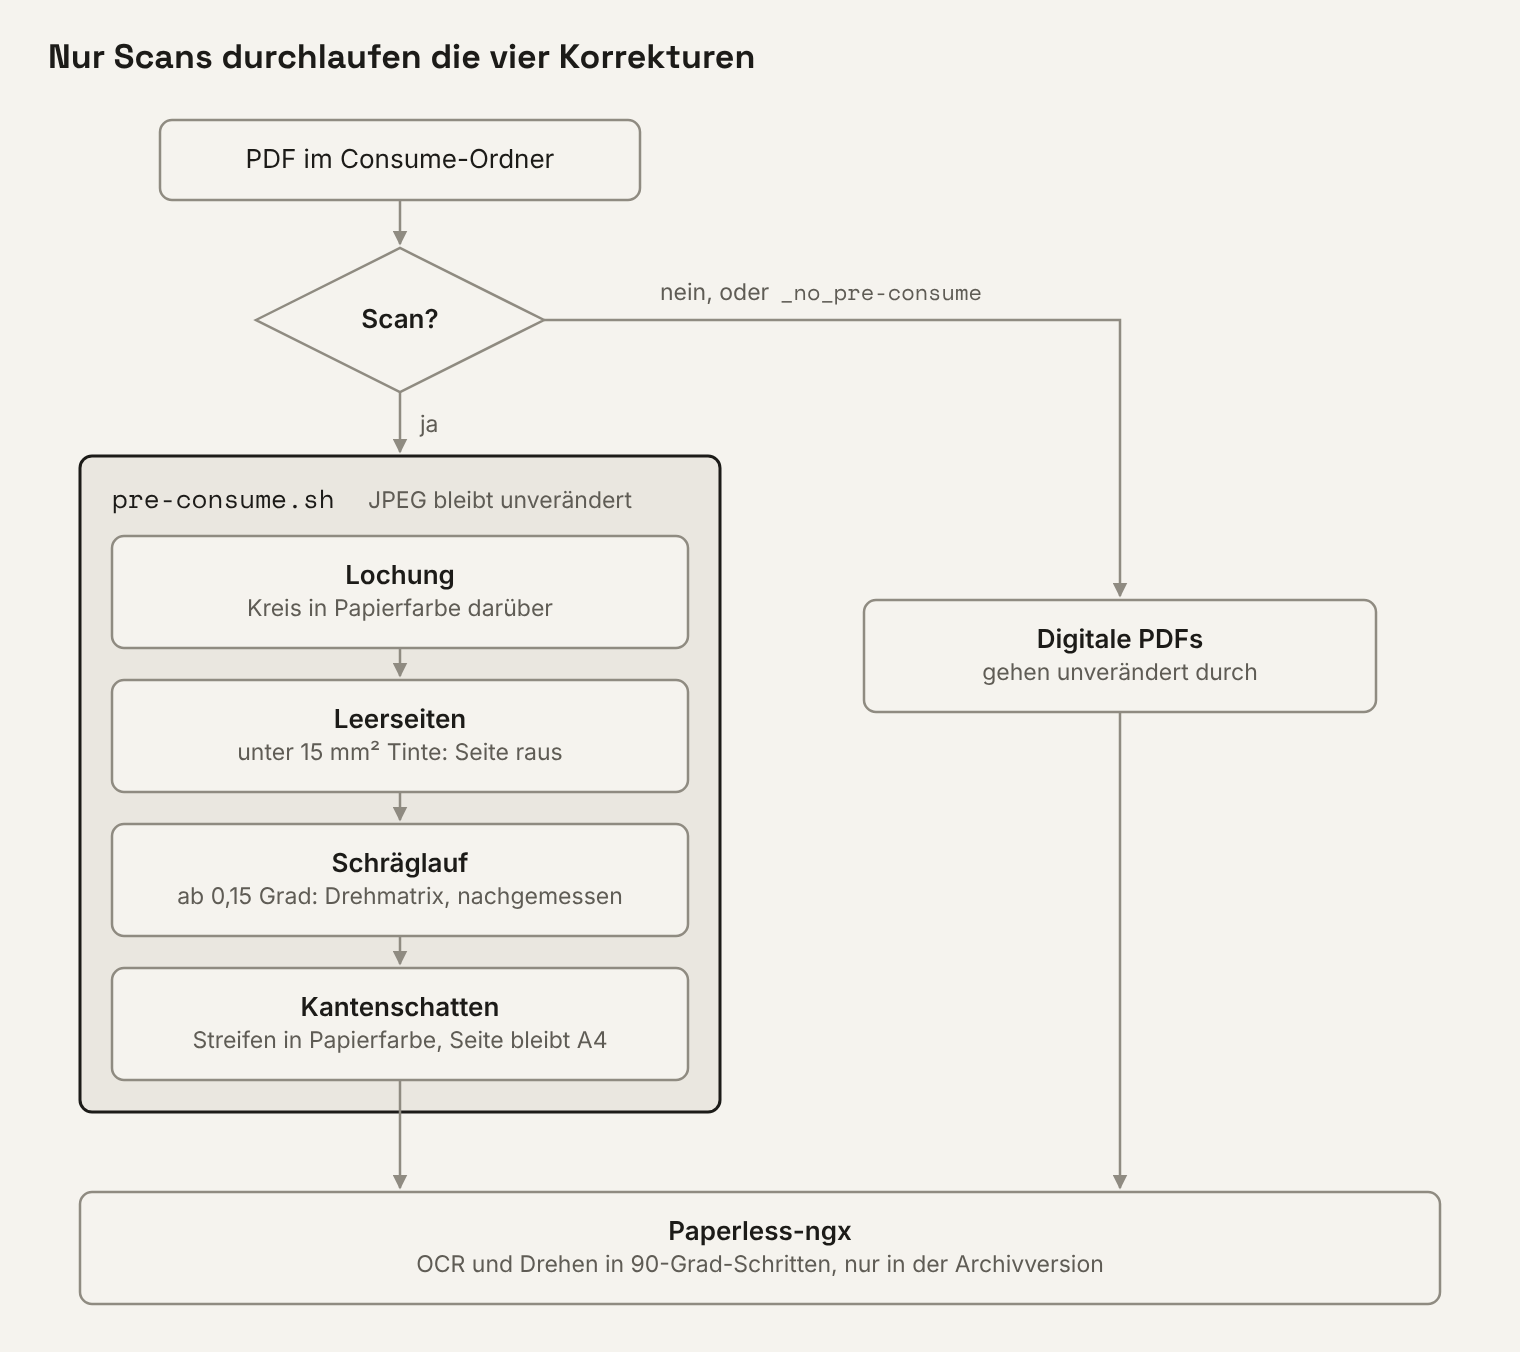
Digitale PDFs nehmen den Weg rechts und kommen unverändert bei Paperless an. Scans laufen links durch alle vier Phasen.
Preflight. Erst wird geprüft, ob überhaupt ein Scan vorliegt. Eine Scanseite ist ein einziges Bild, das die ganze Seite bedeckt, und hat keinen sichtbaren Text. Digitale PDFs fallen hier raus und gehen unverändert durch. Und wer ein Dokument ausdrücklich unbearbeitet haben will, hängt _no_pre-consume an den Dateinamen.
Lochung. Gesucht werden die Halbmond-Schatten in einem 25 mm breiten Randstreifen, links und rechts. Durch jeden Schatten wird ein Kreis gelegt. Akzeptiert werden nur Reihen, die zur Norm passen: zwei Löcher mit 80 mm Abstand (ISO 838) oder drei bis vier in gleichmässigem Abstand, mittig zur Seite. Jedes Loch bekommt eine Kreisfläche in Papierfarbe. Liegt in der Fläche Tinte, z.B. eine Tabellenlinie, bleibt das Loch stehen. Inhalt geht vor Optik.
Leerseiten. Gezählt wird die Fläche wirklich dunkler Pixel, ohne 5 mm Rand. Unter 15 mm² ist die Seite leer. Zum Vergleich: Meine leeren Rückseiten kommen auf 0,0 bis 0,1 mm², eine Seite mit nur einer Kopfzeile auf 50 mm², normale Textseiten auf über 1.000 mm². Eindeutiger gehts nicht.
Schräglauf. ImageMagick misst den Winkel, korrigiert wird ab 0,15 Grad. Das Skript legt dann eine Drehmatrix um den Seiteninhalt und misst nach. Ist der Restwinkel nicht deutlich kleiner, fliegt die Korrektur wieder raus.
Kantenschatten. Der ADF nimmt die Blattkante mit auf, als dünnen grauen Strich am Rand, dort wo das Papier auf den weissen Einzugshintergrund trifft. Solange die Seite schief ist, läuft dieser Strich diagonal über mehrere Pixelzeilen und fällt kaum auf. Erst der Deskew richtet ihn zu einer scharfen waagerechten Linie aus. Und dann sieht man ihn. Deshalb kommt diese Phase zwingend nach dem Schräglauf. Echte Schatten sind dünne, lange, graue Linien direkt an der Kante, gemessen 0,2 bis 1,2 mm dick, und dahinter kommt Papier. Genau das wird geprüft, bevor ein Streifen in Papierfarbe darüberkommt. Die Seite bleibt dabei exakt A4.
Und wenn irgendwo etwas schiefgeht? Dann bricht das Skript trotzdem nie den Import ab. Es schreibt eine Warnung ins Log, und das Dokument wird konsumiert, wie es ist.
Was das Skript tut, steht dabei Seite für Seite im Paperless-Log. Nicht nur „Fertig“, sondern mit Messwert und Entscheidung:
[pre-consume] pre-consume.sh v2.8.2
[pre-consume] Seiten gesamt: 4
[pre-consume] Seite 1: Lochung links ueberdeckt (2 von 2 Loechern)
[pre-consume] Seite 2: Lochung rechts ueberdeckt (2 von 2 Loechern)
[pre-consume] Seite 3: Lochung links ueberdeckt (2 von 2 Loechern)
[pre-consume] Seite 4: Lochung rechts ueberdeckt (2 von 2 Loechern)
[pre-consume] Seite 1: Tinte 1385.2 mm2 -- behalten
[pre-consume] Seite 2: Tinte 0.1 mm2 -- leer, wird entfernt
[pre-consume] Seite 3: Tinte 1420.6 mm2 -- behalten
[pre-consume] Seite 4: Tinte 0.0 mm2 -- leer, wird entfernt
[pre-consume] Behalte Seiten: 1,3
[pre-consume] Dokument hat jetzt 2 Seiten
[pre-consume] Seite 1: Schraeglauf 0.450 Grad -- wird korrigiert
[pre-consume] Seite 2: Schraeglauf 0.084 Grad -- unter Schwelle, unveraendert
[pre-consume] Seite 1: Restwinkel 0.028 Grad -- korrigiert
[pre-consume] Deskew auf 1 Seite(n) angewendet
[pre-consume] Seite 1: Rand ueberdeckt: oben 0.8 mm
[pre-consume] Seite 2: kein Randartefakt
[pre-consume] Fertig
Wenn also mal eine Seite fehlt oder ein Loch stehen bleibt, sieht man sofort, warum und muss nicht rätseln.
Lessons learned
Die erste Fassung war schnell geschrieben. Die guten Regeln kamen erst durch die Dokumente, an denen sie gescheitert ist. Eine Auswahl:
Die Leerseitenerkennung mass den Papierton, nicht den Inhalt. Mein Ausgangsskript, die Vorlage aus dem Paperless-Wiki, summiert per Ghostscript jede Abweichung von Reinweiss über die ganze Seite. Ein minimal grauer Papierton (254 statt 255) ergab auf einer leeren Seite schon 0,70. Eine Seite mit nur einer Kopfzeile kam auf 0,25. Leer also „voller“ als beschrieben. Tja.
Abschneiden ist keine gute Idee. Kantenschatten wurden anfangs per CropBox ausgeblendet. Ergebnis: Einzelne Seiten wurden kleiner als A4, und beim ESt-Bescheid fehlte oben ein Teil der Kopfzeile, weil die im Scan nur 3 mm unter der Kante beginnt. Jetzt wird übermalt statt beschnitten. Und nur noch, was wirklich wie ein Schatten aussieht.
Grau ist nicht gleich Schatten. Der graue Kopfbalken einer Amazon-Rechnung, die Fussleiste der Würzburger Versicherung: für eine naive Erkennung alles Kantenschatten. Echte Schatten sind aber höchstens 1,2 mm dick, Druckflächen ab 3,7 mm. Und digitale PDFs fasst das Skript ohnehin nicht mehr an.
Nicht jeder Scan ist textlos, zwei Dokumente kamen von einem Lexmark-Gerät mit eingebauter Texterkennung. Ein digitales Dokument von der Versicherung hat ein seitenfüllendes Hintergrundbild unter echtem Text. Der Unterschied: Text auf einem Scan liegt, wenn überhaupt, als unsichtbare OCR-Ebene unter dem Bild. Text in einem digitalen PDF ist sichtbar gedruckt. Darauf prüft der Preflight jetzt.
Alles ist rückgängig zu machen. Weil das Skript nur Anweisungen hinzufügt, lässt sich jedes bearbeitete Original zurückdrehen. Getestet: pixelgleich mit dem Rohscan. Das kleine Helferlein pipeline-auf-original.py macht das bei gleicher Paperless Dokument-ID, auf Wunsch gleich mit der aktuellen Skriptversion. Nur gelöschte Leerseiten kommen nicht wieder (wozu auch).
Download
Die drei Skripte gibts hier zum Download:
pre-consume.sh– der Hook selbst, alle fünf Phasenklassifiziere-scans.py– sortiert das bestehende Archiv in gescannt, digital und gemischtpipeline-auf-original.py– dreht frühere Skriptläufe zurück und wendet auf Wunsch die aktuelle Version an
Die Schwellwerte sind auf meinen HP eingestellt und auf das Papier, das bisher bei mir durch den Einzug ging. Bei dünnem Papier darf der Scanner nicht zu lichtstark scannen, sonst scheint die bedruckte Rückseite durch. Bei meinem HP habe ich die Helligkeitseinstellung 4 gewählt.
Bei Deinem Scanner musst Du die Parameter ggf. anpassen, für das Pre-Consume Skript zeigt Dir die Log-Ausgabe, wo.
Schlusswort
Die Qualität meiner in Paperless archivierten Dokumente hat deutlich hinzugewonnen. Und ja, das hätte auch ein Dokumentenscanner gekonnt. Der kostet aber ein paar Hundert zusätzliche Euro. Und er druckt nicht.
Allein geschrieben habe ich die Skripte allerdings nicht. Mitgearbeitet hat Claude Opus 5.5: Code, Messverfahren, Regressionstests. Mein Part waren die Scans, die Sichtkontrolle und das Gemecker, wenn wieder ein Briefkopf als Schatten durchging. Gut 30 Test-PDFs später passt es.
Kommentar verfassen